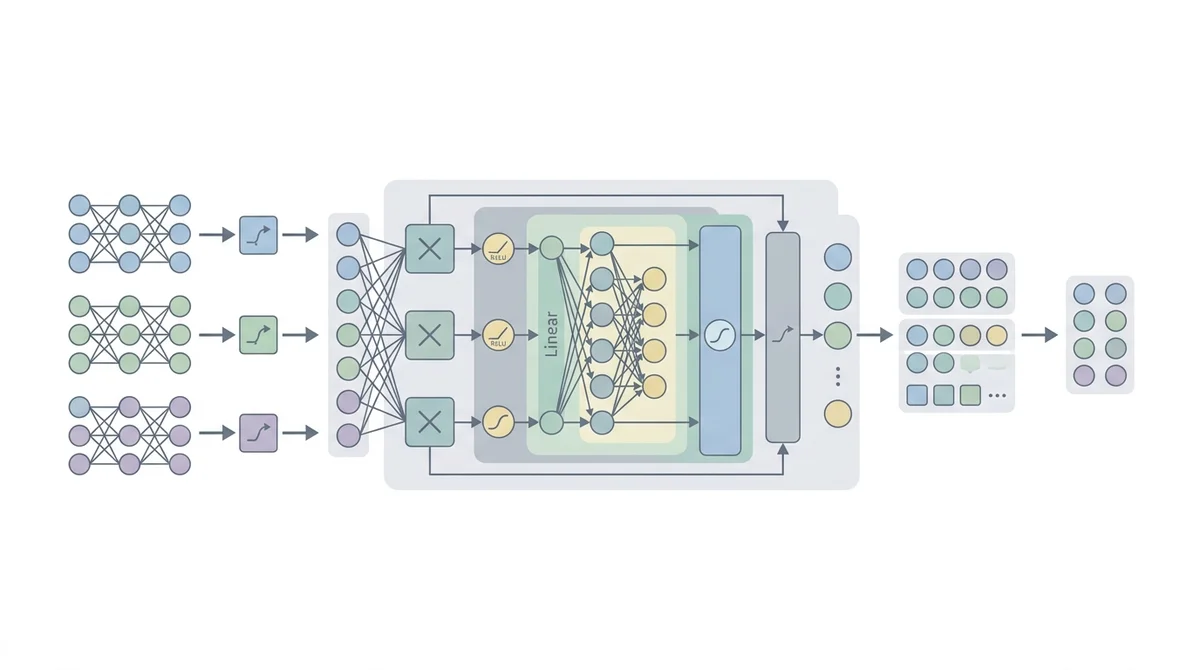
結論から言うと、PyTorchの推論や学習が遅いと感じている開発者には「Profiling in PyTorch (Part 2)」は読む価値があります。一方で、すぐに動くSaaSツールが欲しい方や、PyTorchをまだ触っていない方には早すぎる教材です。まずは無料公開の本記事で全体像をつかみ、実コードはHugging Face Spaces Dev Modeで試すのが最短ルートです。
0. クイックサマリー:この記事でわかること
「torch.compileを付けても速くならない」「nn.Linearの裏側で何が起きているか分からない」と感じていませんか?このまま推測ベースでチューニングを続けると、本来削れるはずのCPUオーバーヘッドや無駄なカーネルを見逃したまま、GPUコストだけが増えていきます。Hugging Faceが2026年6月11日に公開した公式ブログ「Profiling in PyTorch (Part 2): From nn.Linear to a Fused MLP」は、その悩みに対し、nn.Linearの内部動作を実トレース付きで解説する内容になっています。
- nn.Linearが内部で呼ぶ
aten::addmmとエピローグ融合の仕組み torch.compileが効くケースと効かないケースの見分け方- MLPブロックで実現されるカーネル融合の効果
- Hugging Face Spaces Dev Modeで実際にA100上で再現する手順
▶(無料・クレジットカード不要)
1. 「Profiling in PyTorch (Part 2)」とは何か
「Profiling in PyTorch」は、Hugging Faceの研究者Aritra Roy Gosthipaty氏、Rémi Ouazan Reboul氏、Sergio Paniego氏、Pedro Cuenca氏、Sayak Paul氏らが執筆している連載シリーズです。Part 1では torch.add(torch.matmul(x, w), b) という最小構成を題材に、PyTorch Profilerのトレースの読み方、CPUディスパッチチェーン、ローンチオーバーヘッド、そして torch.compile の内部挙動を扱いました。
2026年6月11日公開のPart 2は、その手書きmatmul+addを nn.Linear(bias=True) に置き換え、さらに3層のLinearと活性化関数を組み合わせたMLP(Multilayer Perceptron)まで解説を進めています。公式ブログによると、検証環境はNVIDIA A100-SXM4-80GBで、付属スクリプト 02_linear.py、03_simple_mlp.py、03_kernels_mlp.py はGitHub上で公開されています。
連載のターゲットは「ディープラーニングモデルを書いているが、なぜ遅いのかをプロファイラで根拠を持って説明できない」という中級層のPyTorchユーザーです。SaaSとは異なり記事自体は完全無料で、Hugging Faceアカウントすら不要で全文を読めます。
2. 主要トピックの詳細:nn.LinearはなぜGEMM 1本で済むのか
Part 2の中核は「nn.LinearはPart 1で見たmatmul+addと同じことをしているが、PyTorch内部では単一のcuBLAS GEMMカーネルで処理される」という発見です。
2.1 aten::tはGPUカーネルを起動しない
プロファイラトレースを拡大すると、aten::addmm の前に aten::t(転置)が並んでいます。公式ブログでは「aten::tはデータをコピーせず、テンソルのメタデータ(shapeとstride)をCPU上で書き換えるだけ」と明記されています。GPUレーンには対応するカーネルが現れないため、これは事実上ゼロコストの操作です。
2.2 バイアス加算が「消える」エピローグ融合
nn.Linearの bias=True 構成では、プロファイラ上に aten::addが現れません。これは cuBLAS GEMMカーネルがエピローグとしてバイアス加算を内蔵しており、HBM(High Bandwidth Memory)への書き戻し直前にバイアスを足してから一度だけ書き出すためです。メモリトラフィックを半減できるため、推論レイテンシに直接効きます。
2.3 単一Linearに対して torch.compile はほぼ効かない
公式ブログでは --compile を付けた場合と付けない場合のトレースを比較し、「GPU側で動くカーネルは同じcuBLAS GEMMで、CPU側で数マイクロ秒のディスパッチオーバーヘッドが消えるだけ」と結論づけています。つまり「遅いと思ったらとりあえずtorch.compile」という反射は、単一GEMMでは見当違いであることが、実トレース付きで示されています。
3. 日本語ユーザー向け評価
本記事はHugging Face公式ブログのため、以下の点を客観的に整理します。
- UI言語:ブログ本文・コードコメントともに英語のみ。日本語訳の公式版は本記事執筆時点では公式サイト上に存在しません。
- 日本円決済:ブログ閲覧自体は無料。Hugging Faceの有料プラン(Pro $9/月、Team $20/月/ユーザー)はクレジットカード決済で、為替レートに依存します(2026年6月のレート想定で月額約1,400〜3,100円)。
- 日本語サポート:Hugging Faceの公式サポート窓口は英語ベース。Discord・フォーラム経由でのコミュニティサポートも英語中心。
- 日本語出力品質:本ブログはモデル出力ではなく解説記事のため該当しません。コードサンプル中のログ・コメントは英語表記です。
日本語UIや日本語サポートが必須な方には、機械翻訳併用か、後述する社内勉強会形式での読み合わせが現実的な選択肢になります。
4. 料金プラン(Hugging Faceプラットフォーム側)
ブログ自体は無料公開ですが、Part 2で紹介されているスクリプトをそのまま再現する場合、Hugging Face Spaces Dev Modeまたはハードウェア課金が関係します。公式料金ページの情報を基に整理します。
| プラン/ハードウェア | 月額/時間額 | 日本円目安 | 主な用途 |
|---|---|---|---|
| ブログ閲覧(無料) | $0 | 0円 | 記事+スクリプト閲覧のみ |
| CPU Basic(Spaces) | 無料 | 0円 | 軽量検証・コード理解 |
| ZeroGPU(Pro特典) | Pro $9/月 | 約1,400円/月 | RTX Pro 6000 Blackwell(最大96GB)を共有利用 |
| Nvidia T4 – small | $0.40/時 | 約62円/時 | 小規模MLPのプロファイル検証 |
| Nvidia A100 – large | $2.50/時 | 約390円/時 | Part 2の検証環境と同等の80GB A100 |
| Team プラン | $20/月/ユーザー | 約3,100円/月 | チームでの共同検証・組織管理 |
解約はいつでも可能で、決済はStripeを採用しています。記事を読むだけなら登録すら不要な点は、日本人読者の心理的ハードルが低いポイントです。
▶(無料・クレジットカード不要)
5. Hugging Face Spaces Dev Modeで実際に試す方法
「実際に試したい」という読者向けに、公式ブログ記載の手順を整理します。公式チュートリアルを見ると、以下のフローでA100上での再現が可能になっています。
- Hugging Faceアカウントを無料作成する(メールアドレスのみ)
- Spacesで新規Spaceを作成し、Dev Modeを有効化
- ハードウェアでNvidia A100 – large($2.50/時)を選択
- 公式リポジトリから
02_linear.pyをクローン uv run 02_linear.py --batch 1024 --in_dim 32 --out_dim 64を実行uvx trace-util traces -b tracesでトレースをHFバケットへ同期し、Perfettoで可視化
公式ドキュメントでは「Hugging Face Jobsパイプラインからも実行可能」と記載されており、CI/CDからの定期プロファイリングにも適用できます。Spaces Dev ModeはVS Code風UIをブラウザで利用できるため、ローカルにCUDA環境を構築できない方でも約3〜5分で検証を始められる構成です。
6. 業務で使える具体的な活用例
Part 2の知識を、日本語ビジネス環境のワークフローに落とし込んだ具体例を紹介します。
6.1 画像生成ワークフローの最適化
ComfyUIやStable Diffusion WebUIのカスタムノードを書く際、推論ボトルネックの特定にPyTorch Profilerは有効です。Part 2で学んだ「単一GEMMにはtorch.compileがほぼ効かない」という知識があれば、不必要に torch.compile を全層に適用してコンパイル時間を浪費する事態を避けられます。
6.2 自動化パイプライン組み込み
n8nやAirflowからHugging Face Jobs APIをHTTPリクエストで叩く構成にすれば、「モデル更新→自動プロファイリング→トレースをSlackに通知」という社内自動化を組めます。週次でMLPの実行時間が劣化していないかを機械的にチェックする運用が現実的です。
6.3 社内勉強会・MLOps研修への組み込み
議事録作成系AIや社内RAG基盤を運用する企業では、推論コスト削減が経営課題になりがちです。本ブログのPart 1〜Part 2は「プロファイラの読み方」を1時間の勉強会で習得できる教材として使えます。週次レポートに「今週学んだ最適化観点」として追加すれば、エンジニア育成コストを抑えながらコスト最適化文化を醸成できます。
7. 競合・代替コンテンツとの比較
PyTorchプロファイリング学習リソースを客観的に比較します。
| コンテンツ | 主な特徴 | 料金 | 日本語対応 | レベル |
|---|---|---|---|---|
| 実トレース付き・スクリプト公開・A100検証 | 無料 | 英語のみ | 中級 | |
| PyTorch公式 Profiler Recipe | API仕様中心・最小サンプル | 無料 | 英語のみ | 初級〜中級 |
| NVIDIA Nsight Systems | GPU全体プロファイリング・GUIが強力 | 無料(CUDA同梱) | 英語のみ | 上級 |
| 有料オンライン講座(Udemy等) | 動画解説・字幕で日本語化可能 | 1,500〜24,000円 | 一部あり | 初級〜中級 |
「英文記事は読めるが体系的な教材が欲しい」開発者にはHugging Faceの本シリーズが最も費用対効果が高いと考えられます。一方、動画で学びたい方は有料講座、GPU全体を俯瞰したい方はNsight Systemsとの併用が有効です。
8. こんな人におすすめ / こんな人には向かない
おすすめの人
- PyTorch Profilerのトレースを読めるようになりたい中級ML開発者
- 推論コストを削減したいMLOps/プラットフォームエンジニア
- ComfyUI・Diffusers系の独自ノードを書くPython開発者
向かない人
- PyTorchをまだ書いたことがない方 → まず公式チュートリアル「60 Minute Blitz」から
- SaaSとして即座に業務効率を上げたい方 → Hugging Face Inference Endpointsの方が適切
- 日本語サポートが必須の方 → 国内ベンダーのMLOps SaaSや書籍を検討
9. 総合評価
★★★★☆(4.5/5.0)
無料で公開されているとは思えない密度の高い解説と、A100で再現可能なスクリプト一式が揃っている点が高評価です。日本語版がない点・初学者には難易度が高い点で星半分を減点しましたが、PyTorchで真剣にパフォーマンスチューニングをするなら必読シリーズと言えます。
10. まとめ
Hugging Face公式ブログ「Profiling in PyTorch (Part 2): From nn.Linear to a Fused MLP」のポイントは以下の3点です。
- nn.LinearはcuBLAS GEMM 1本で動き、バイアス加算はエピローグ融合で吸収される
- 単一Linearにtorch.compileを掛けてもGPUカーネルは変わらない
- MLP以上の多層構成で初めてカーネル融合のメリットが見えてくる
こんな方には特におすすめ:自社のPyTorchモデルの推論コストを根拠を持って下げたいエンジニア、MLOps基盤の運用責任者、ComfyUIや独自パイプラインの最適化を任されている方。今日30分だけ時間を確保し、Hugging Faceアカウントを作って 02_linear.py を手元で動かせば、明日からプロファイラトレースが「読める景色」に変わります。
▶(無料・クレジットカード不要)

コメント